Open Inference Review
Inference Throughput
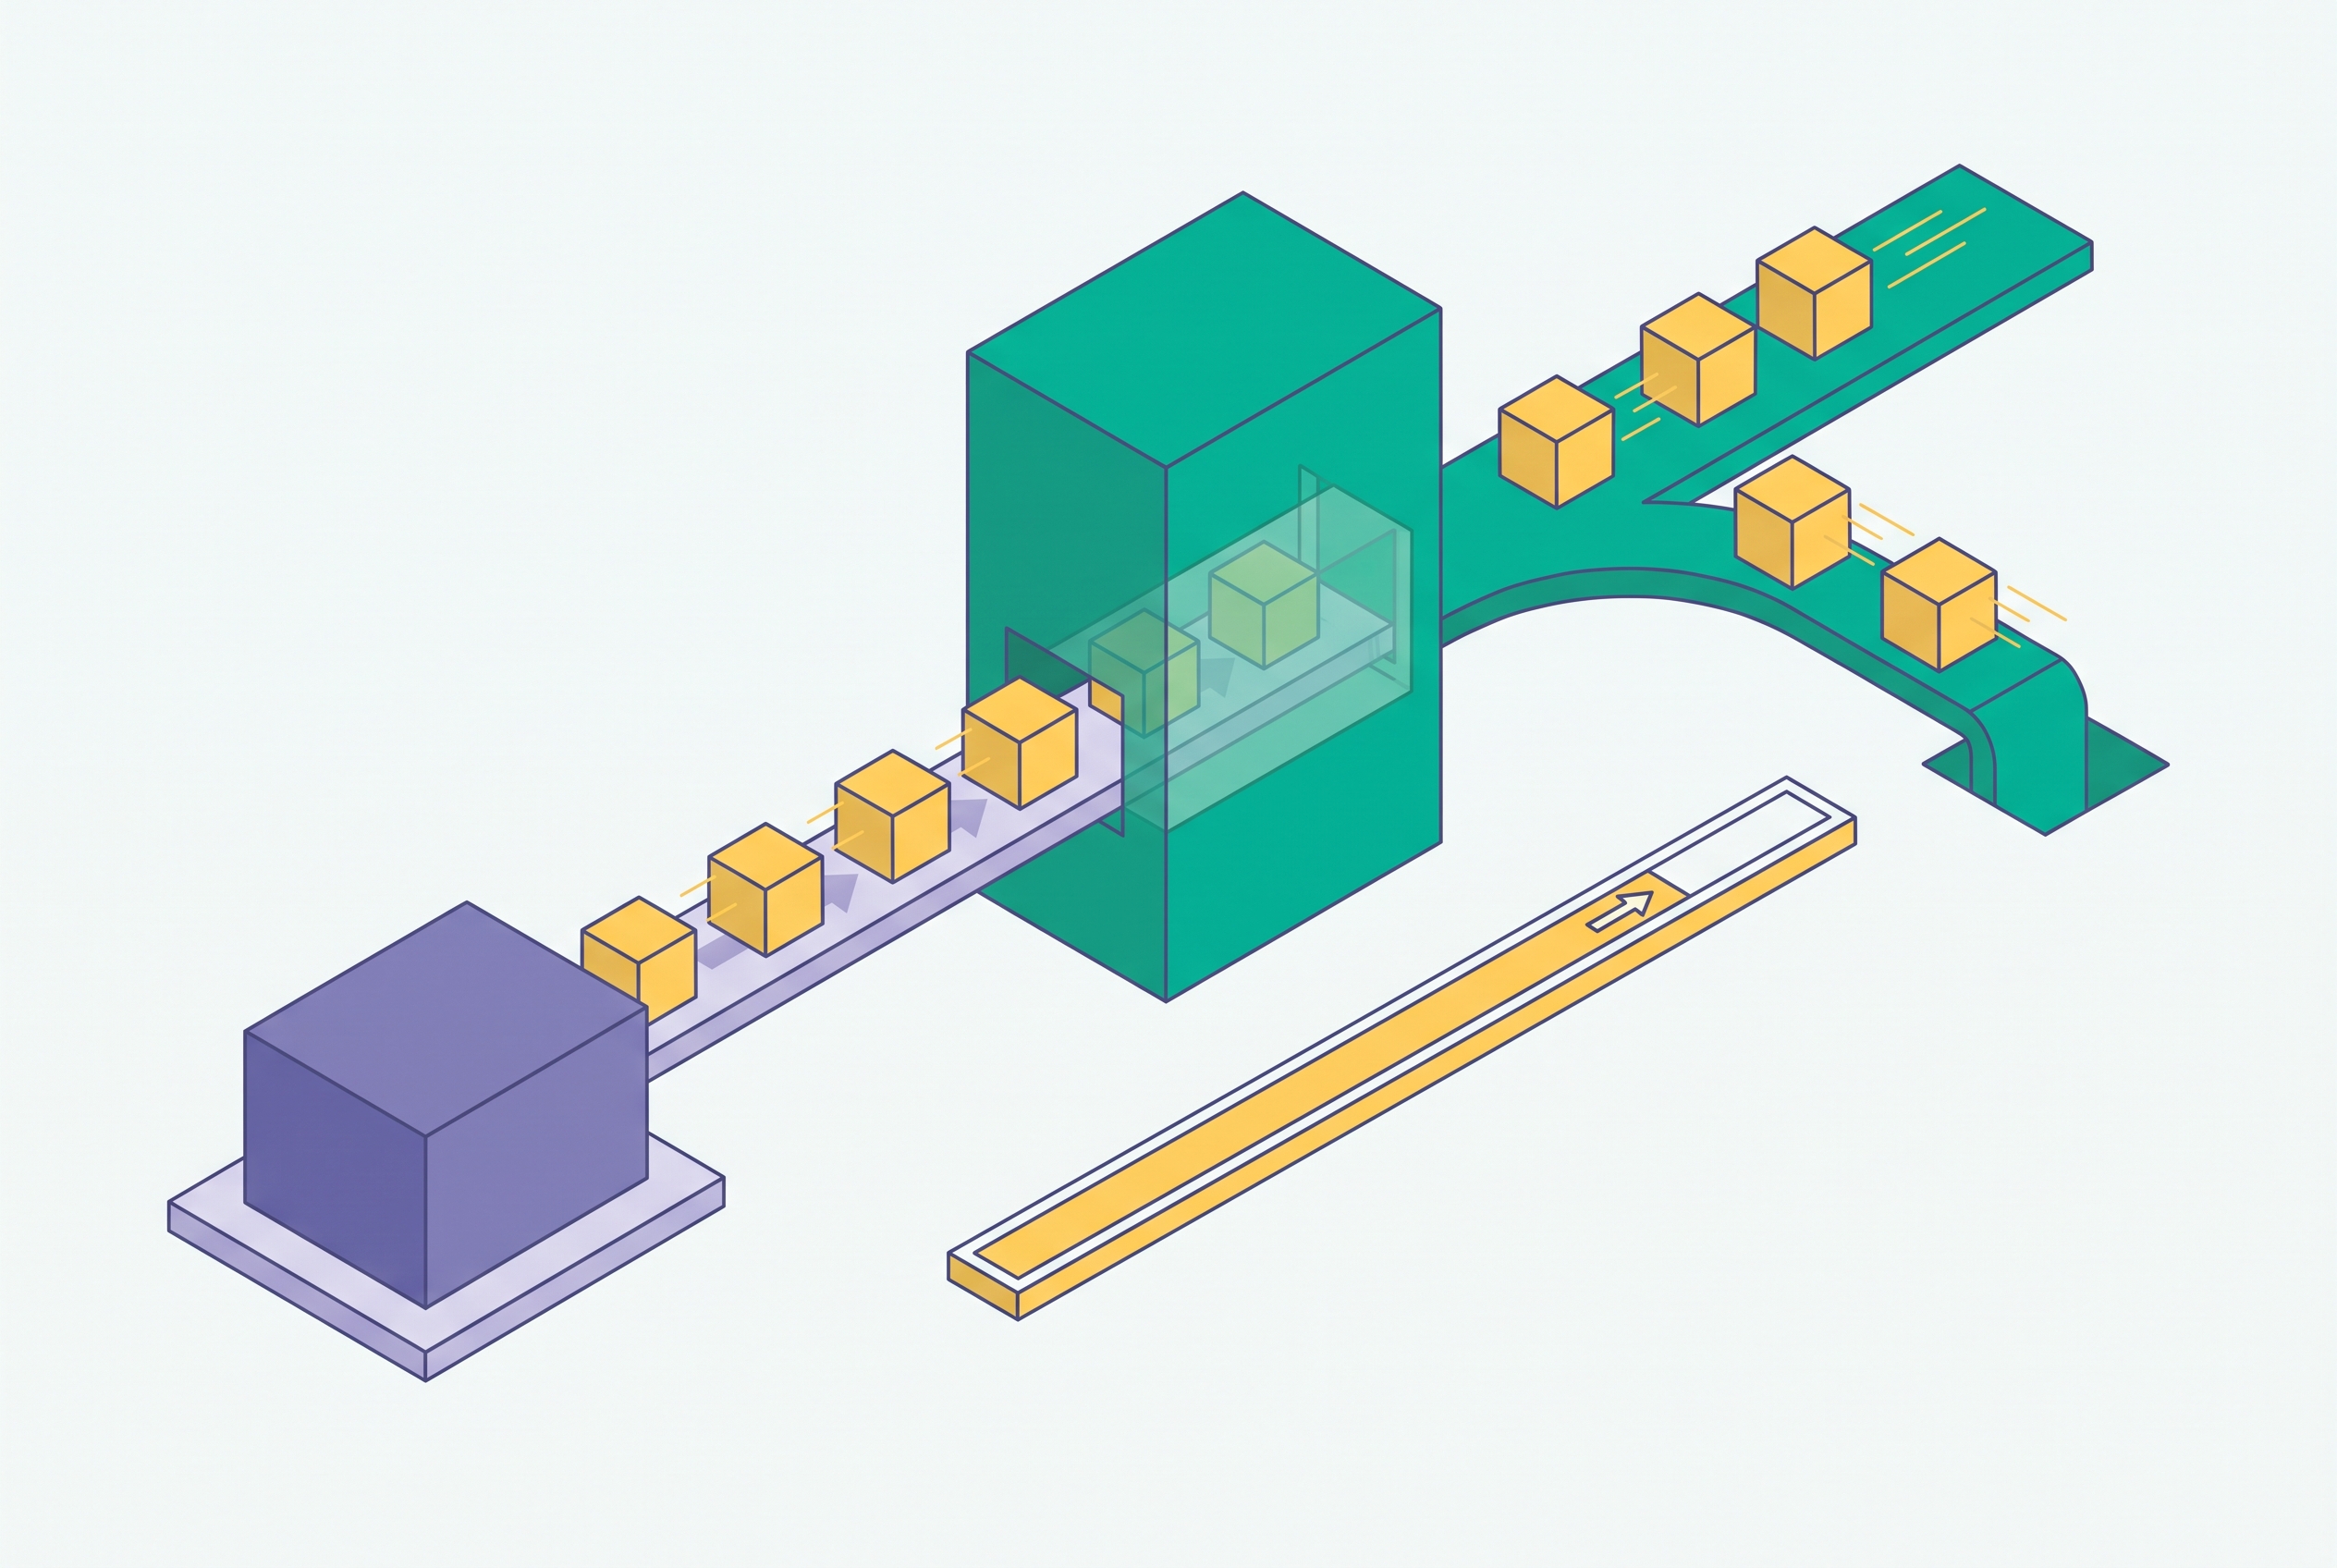
A faster way to run large language models without sacrificing output quality.
Marcus Oyelaran·9 min read